
项目部署到 Cloudflare Workers
发给 ChatGPT / Claude 等 AI,可更快消化本页并上手上站。
Cloudflare Workers 生产部署完整实战指南
本项目基于 ShipAny GPT Image2 底座(TanStack Start + React 19 + Nitro + Drizzle ORM + better-auth + Tailwind CSS v4)打造,针对 Cloudflare Workers 边缘运行时进行了深度优化与适配。
💡 部署包体积与免费计划支持说明
Cloudflare Workers 在免费计划(Free Plan)上的 Worker 体积上限为 3 MB(在付费计划 Paid Plan 上为 10 MB)。
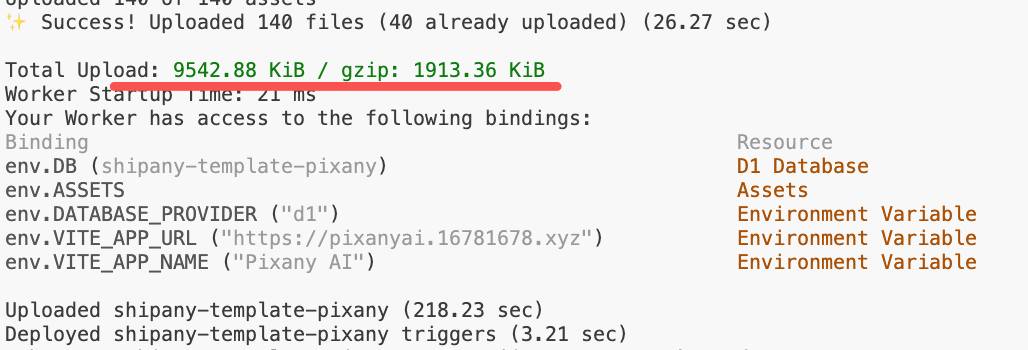
在构建 Worker 时,wrangler 会显示原始文件大小和 gzip 压缩大小,Cloudflare 仅以压缩后(gzip)的大小计算是否超限。
如图所示,本项目构建后的实际压缩大小约为 1.86 MB(远低于 3 MB 上限),这意味着即使您使用 Cloudflare 免费计划,也可以完全无压力地直接部署上线!
1、登录 Cloudflare 并创建 D1 数据库
# 检查登录状态
pnpm cf:whoami

# 创建远程 D1 数据库(记录返回的 database_id)
pnpm exec wrangler d1 create shipany-template-gpt-image2
2、配置 wrangler.jsonc
cp wrangler.example.jsonc wrangler.jsonc
编辑项目根目录下的 wrangler.jsonc,填入刚才生成的 database_name 与 database_id,以及生产域名:
// Cloudflare Workers deploy config — TEMPLATE.
// The /deploy-cloudflare skill copies this to wrangler.jsonc (gitignored, your
// working copy) and fills in the real values (D1 database_id, production URL).
// `pnpm cf:build` (NITRO_PRESET=cloudflare_module) merges wrangler.jsonc into
// the generated .output/server/wrangler.json; deploy with `pnpm cf:deploy`.
{
  "$schema": "node_modules/wrangler/config-schema.json",
  "name": "shipany-template-gpt-image2",
  "compatibility_flags": ["nodejs_compat"],
  "observability": {
    "enabled": true,
  },
  "vars": {
    "DATABASE_PROVIDER": "d1",
    // Server-side runtime fallbacks for the build-time VITE_* values — keep in
    // sync with .env.production (better-auth trustedOrigins, payment callbacks).
    "VITE_APP_URL": "https://<worker>.<your-subdomain>.workers.dev",
    "VITE_APP_NAME": "GPT Image2",
  },
  "d1_databases": [
    {
      "binding": "DB",
      "database_name": "shipany-template-gpt-image2",
      "database_id": "REPLACE_WITH_OUTPUT_OF_WRANGLER_D1_CREATE",
      "migrations_dir": "drizzle",
    },
  ],
  // ── Postgres via Hyperdrive (instead of D1) ────────────────────────────────
  // 1. npx wrangler hyperdrive create <name> --connection-string="postgres://..." (your direct PG url)
  // 2. Set vars.DATABASE_PROVIDER to "postgresql" and remove the d1_databases block
  // 3. Uncomment and fill the binding (the build keeps the postgres driver in
  //    the bundle when DATABASE_PROVIDER=postgresql — see vite.config.ts):
  // "hyperdrive": [
  //   { "binding": "HYPERDRIVE", "id": "REPLACE_WITH_OUTPUT_OF_WRANGLER_HYPERDRIVE_CREATE" }
  // ]
  //
  // Other optional bindings — uncomment when needed:
  // "kv_namespaces":  [{ "binding": "CACHE",  "id": "..." }],
  // "r2_buckets":     [{ "binding": "BUCKET", "bucket_name": "..." }],
  "triggers": {
    "crons": ["0 16 * * *"] // Daily 00:00 UTC+8 (16:00 UTC) storage migration
  }
}
补充说明wrangler.jsonc中部分配置
注意:本项目使用 SQLite 版 Durable Objects(
new_sqlite_classes),Workers Free / Paid 计划均可完整保留durable_objects、migrations;triggers.crons同样建议保留
-
Durable Objects 限流器(
durable_objects&migrations):- 代码对应:
src/durable-objects/provider-generate-rate-limiter.ts与src/routes/api/ai/generate.ts中的consumeProviderSlidingWindowRateLimit。 - 作用:Cloudflare Workers 处于分布式边缘节点,DO 用于在所有边缘实例间维护全局原子级的供应商调用滑动窗口限流,避免多并发请求打爆上游 AI 供应商(KIE、Replicate 等)的配额与并发限制。
- 说明:用于跨实例共享限流状态。SQLite 版 Durable Objects 在 Workers Free 计划可用,无需为此升级 Paid;未绑定 DO 时代码会自动回退为单机内存限流。
- 代码对应:
-
定时触发器(
triggers.crons):- 代码对应:
src/plugins/ai-storage-migration.ts中注册的cloudflare:scheduled事件钩子。 - 作用:每天北京时间 00:00(16:00 UTC)自动触发执行
syncDailyAITasksToR2()(将供应商临时视频链接同步转存至 R2 持久化存储,防止失效)和expireTimedOutTasks()(清理超时卡住的任务)。没有此触发器,定时转存逻辑在 Workers 上将无法自动运行。
- 代码对应:
3、生成并应用远程 D1 数据库迁移
# 1. 生成 SQL 迁移文件
pnpm db:generate
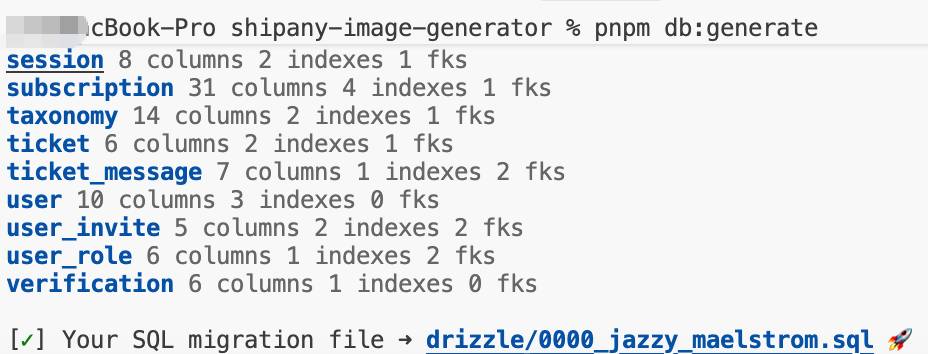
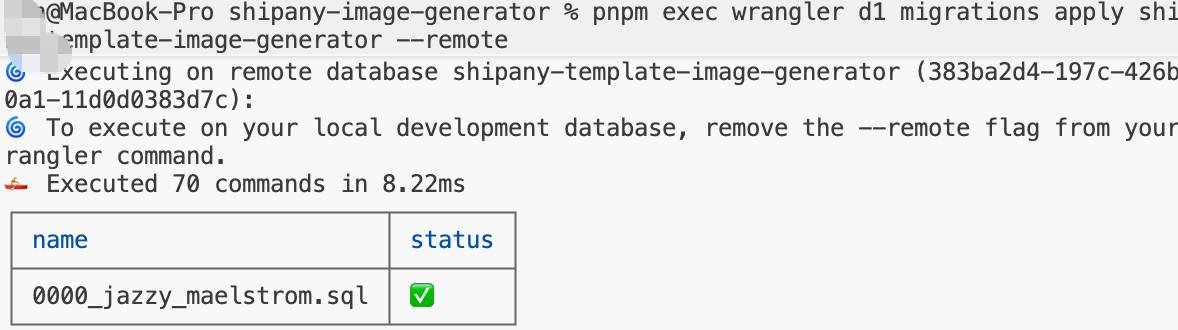
# 2. 应用迁移至远程 D1 数据库(shipany-template-gpt-image2为你的数据库名,可自行修改)
pnpm exec wrangler d1 migrations apply shipany-template-gpt-image2 --remote
4、注入线上 AUTH_SECRET 与加密密钥
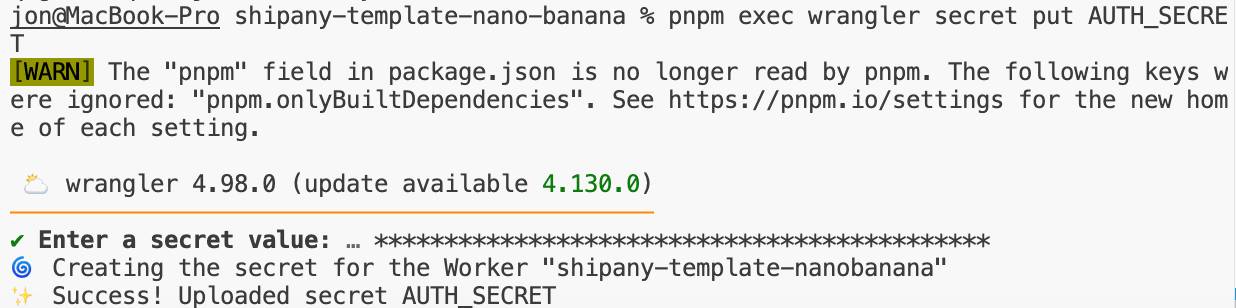
# 注入 AUTH_SECRET 密文(输入一个 32 字节以上的安全随机串)
pnpm exec wrangler secret put AUTH_SECRET

# (选做)注入后台敏感设置加密密钥
pnpm exec wrangler secret put CONFIG_ENCRYPTION_KEY
5、构建并部署上线
pnpm cf:deploy内部会自动触发node scripts/db-setup.mjs,接着调用 Nitro 执行生产环境编译打包(NITRO_PRESET=cloudflare_module vite build),最后调用wrangler deploy发布至全球边缘网络。编译打包通常持续 1~2 分钟。
pnpm cf:deploy
部署完成后,终端会输出分配的 *.workers.dev 访问链接。此时项目已成功运行在 Cloudflare Workers 上!
📌 后续更新维护:日常代码修改后,只需再次运行
pnpm cf:deploy即可一键热更新发布。
6、绑定自定义域名(让网站正式上线)
为了让用户通过专属独立域名访问,需要为 Workers 绑定自定义域名。
方式 1:域名托管在 Cloudflare(推荐)
如果域名是在第三方服务商(Spaceship、GoDaddy、NameSilo、Namecheap、腾讯云、阿里云等)购买的,可以将 DNS 托管到 Cloudflare:
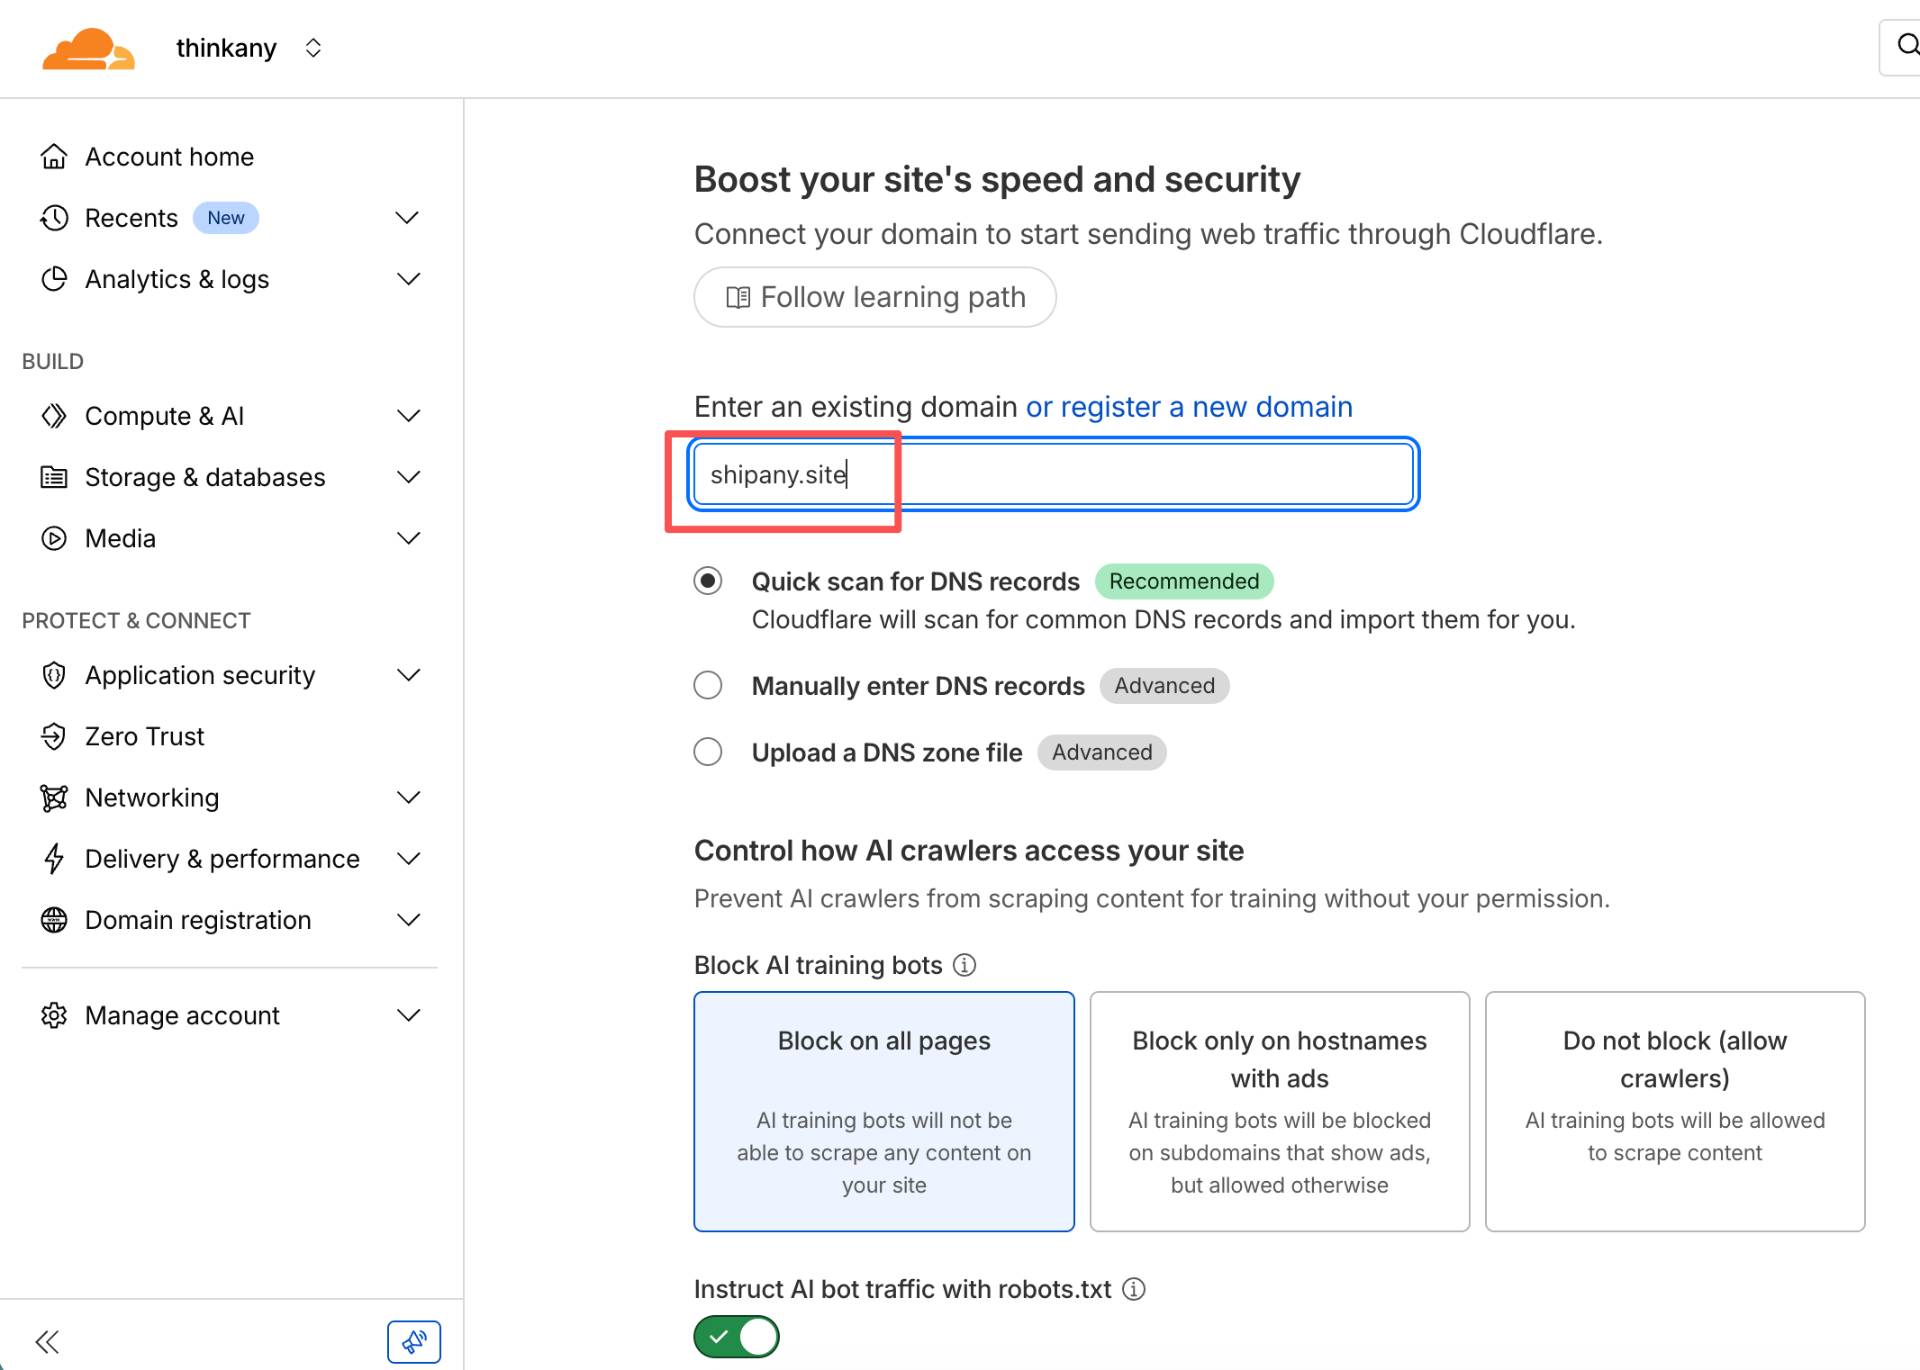
前往你的域名注册商后台,将域名的 NAMESERVER(DNS 服务器)修改为 Cloudflare 分配给你的 Nameservers(例如):
graham.ns.cloudflare.com
ullis.ns.cloudflare.com
方式 2:在 Cloudflare Workers 后台直接绑定自定义域名
进入 Cloudflare 控制台:
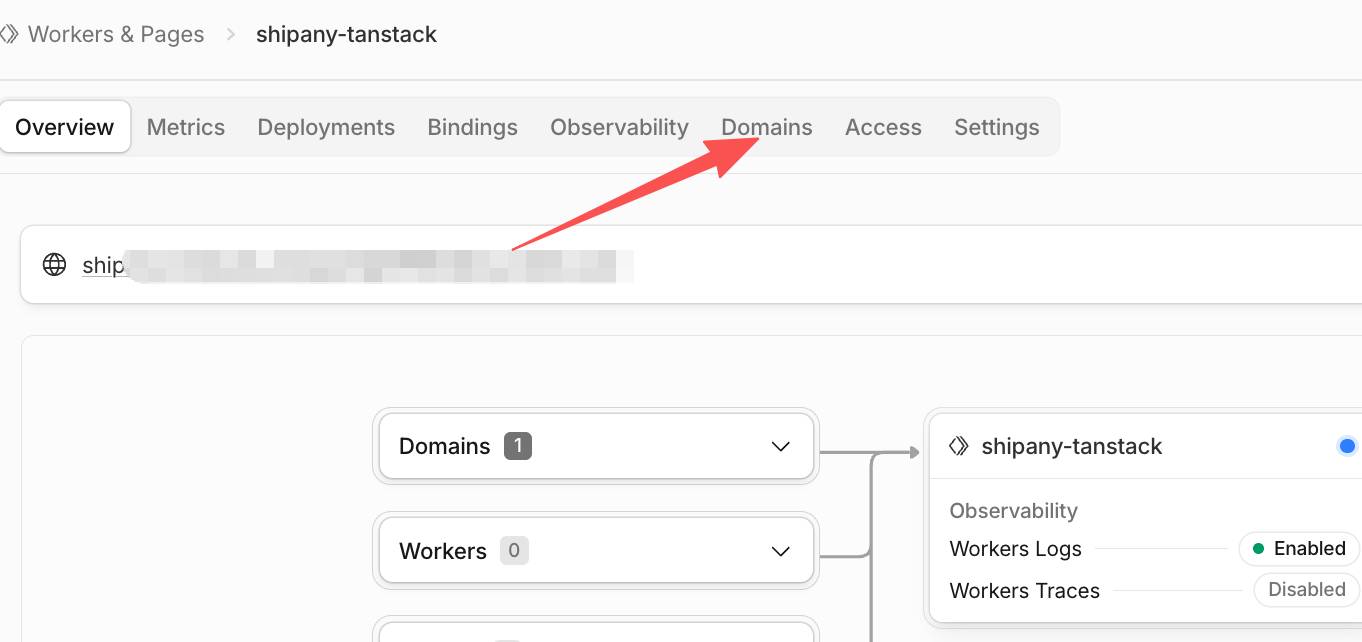
- 进入 Compute (Workers) > Workers & Pages,点击你部署的 Worker 项目。
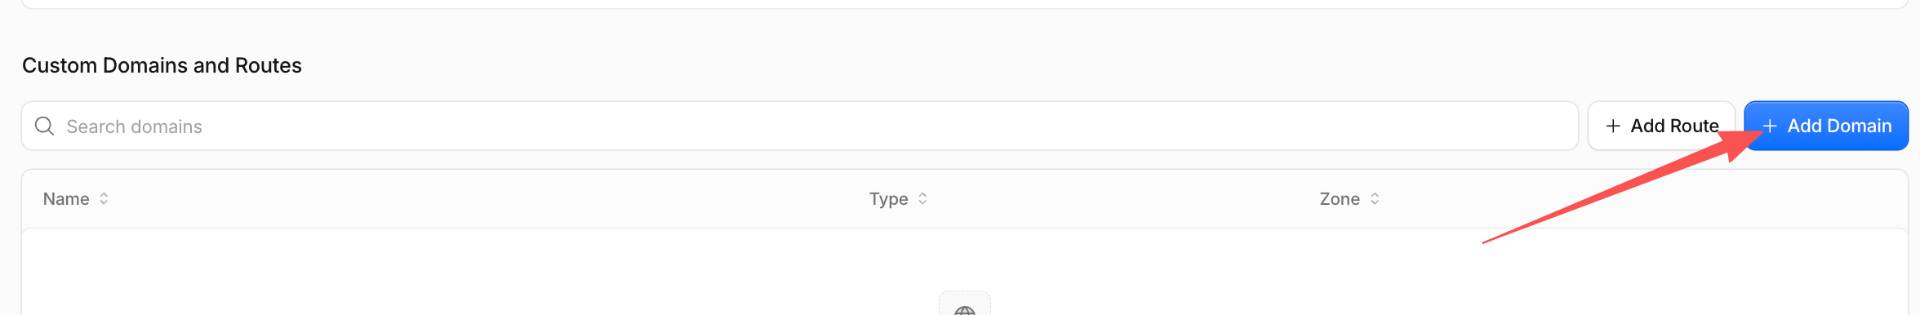
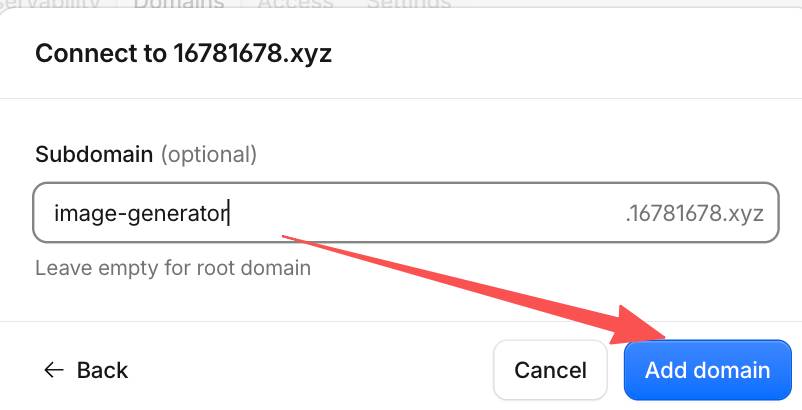
- 进入 Domains,在 Custom Domains 处点击 Add 按钮。
-
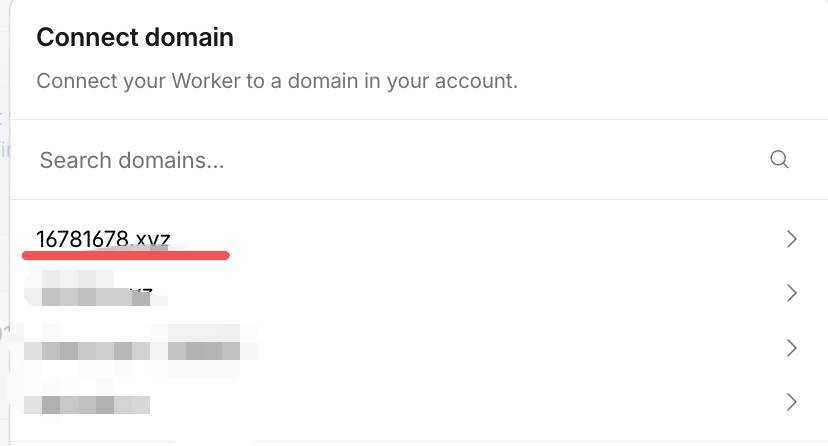
输入你的自定义域名(可以是根域名如
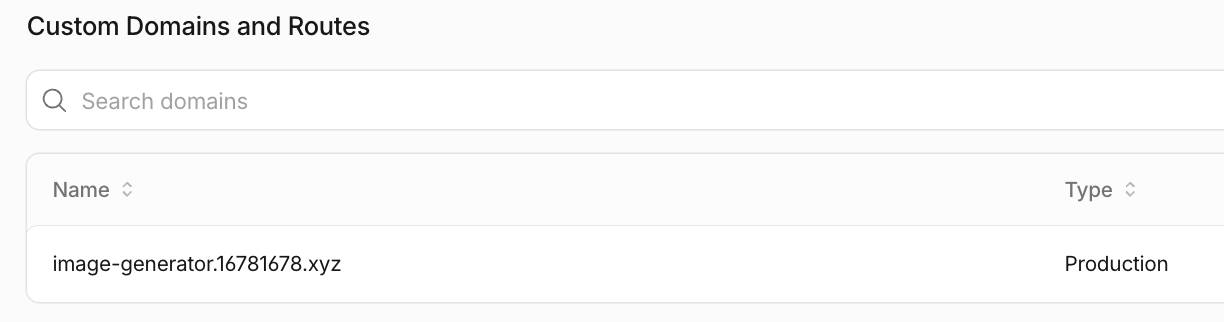
yourdomain.com,也可以是二级域名如app.yourdomain.com),点击 Add Domain:
-
Cloudflare 会自动为该域名签发 SSL 证书并配置 DNS 解析,稍等几分钟解析生效后,即可通过该域名访问前台与后台!
7、线上超管账号权限初始化
上线成功后:
- 打开线上网站注册一个新账号(例如
your-admin@example.com)。 - 在本地向 AI 助手发送指令,或执行以下 D1 远程命令完成超管角色绑定:也可以直接告知 AI:
# 为已注册的用户赋予 super_admin 权限 pnpm exec wrangler d1 execute shipany-template-gpt-image2 --remote --command="INSERT OR REPLACE INTO user_role (id, user_id, role_id) SELECT lower(hex(randomblob(16))), u.id, r.id FROM user u, role r WHERE u.email = 'your-admin@example.com' AND r.name = 'super_admin';"我已在线上注册账户 your-admin@example.com,请给远程 D1 数据库执行 rbac:init 并且分配 super_admin 角色。
8、【选做】使用外部数据库:配置 Hyperdrive 加速(PostgreSQL / Supabase)
如果你不想使用 D1,而是使用外部自建 PostgreSQL、Neon 或 Supabase,建议开启 Cloudflare 的 Hyperdrive 连接池加速服务,大幅缩减跨国查询延迟。
8.1 在 Cloudflare 控制台创建 Hyperdrive
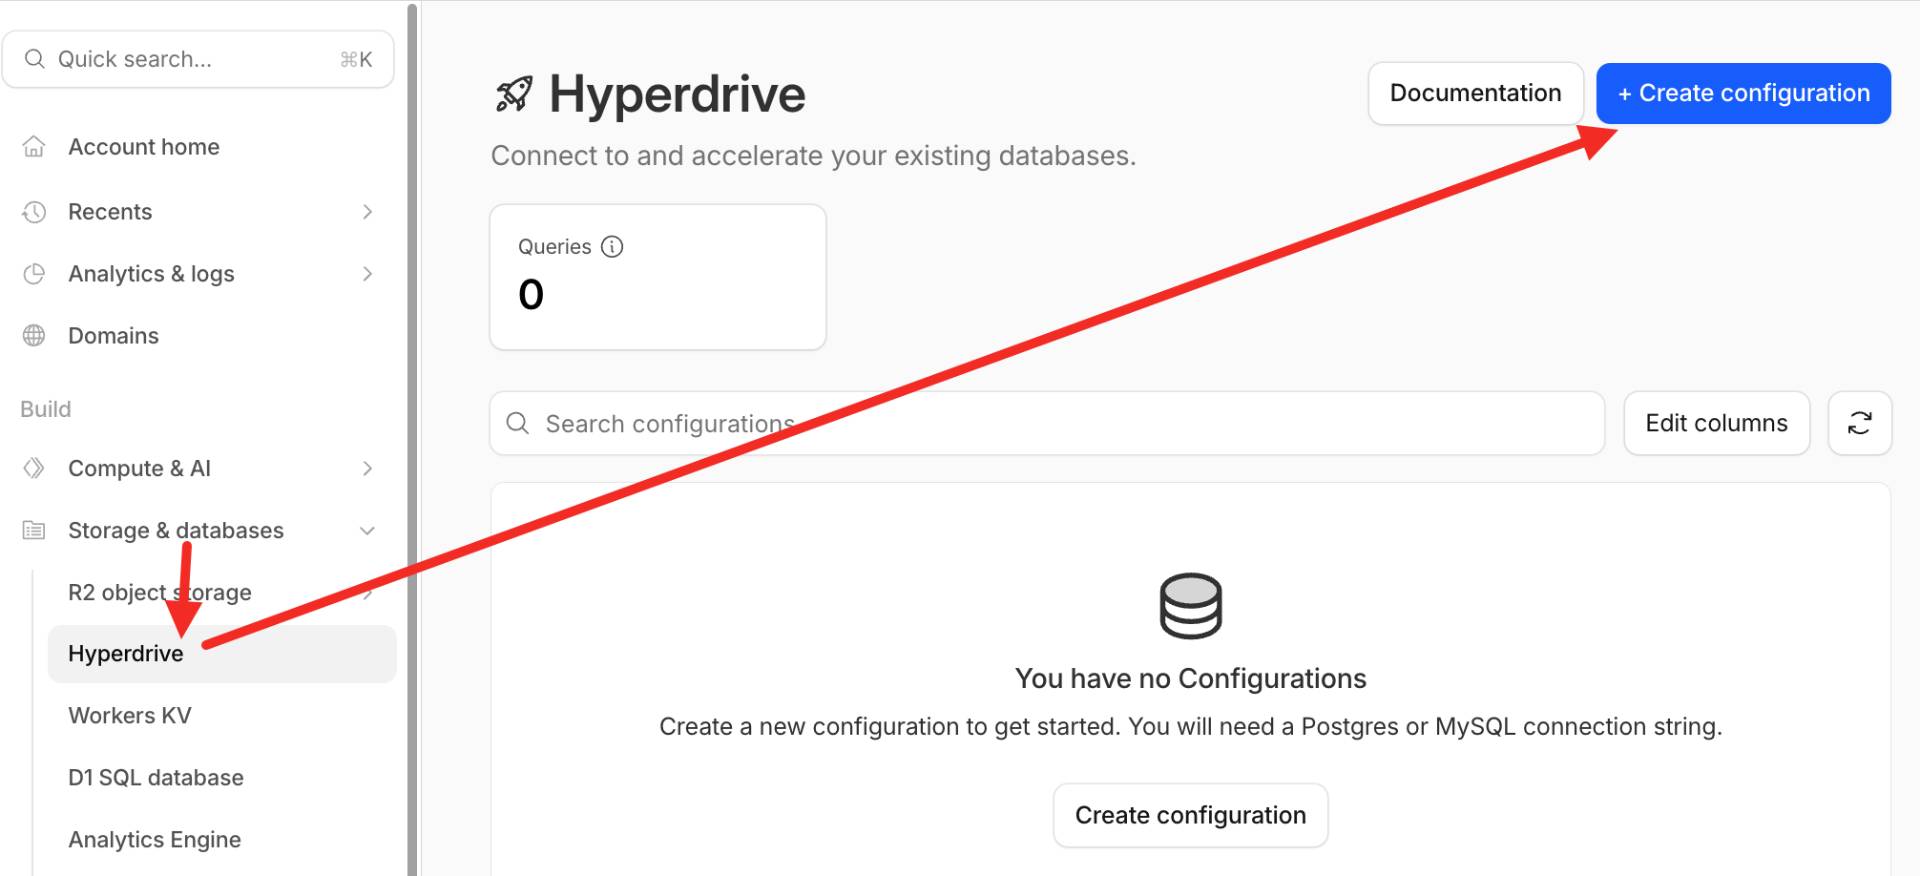
- 进入 Cloudflare 控制台,点击 Storage & databases > Hyperdrive,点击 Create configuration。
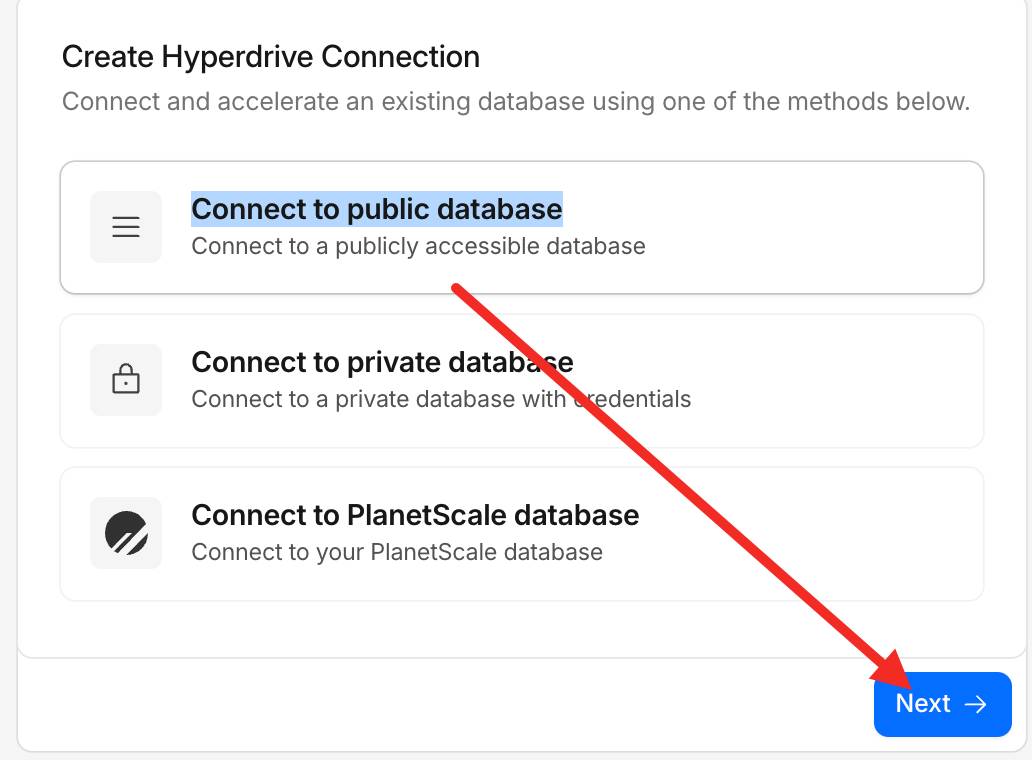
- 选择 Connect to public database,输入你的数据库连接信息:
- Configuration name:自定义名称(如
shipany-hyperdrive) - Connection String:填写外部数据库的连接串(例如 Supabase 提供的直连地址):
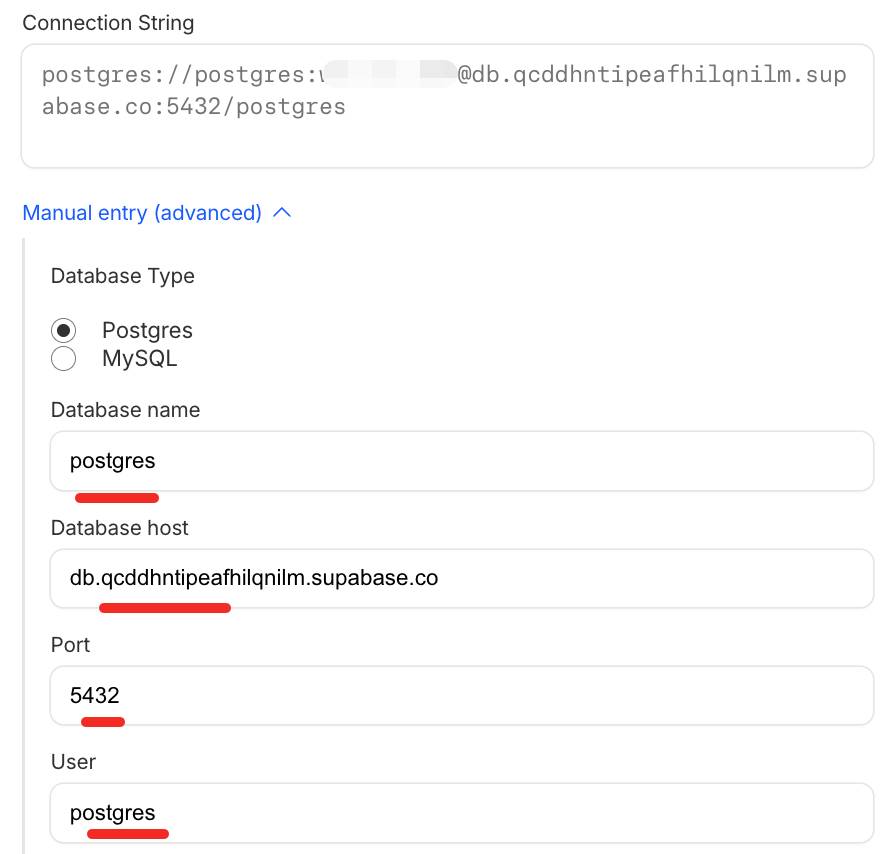
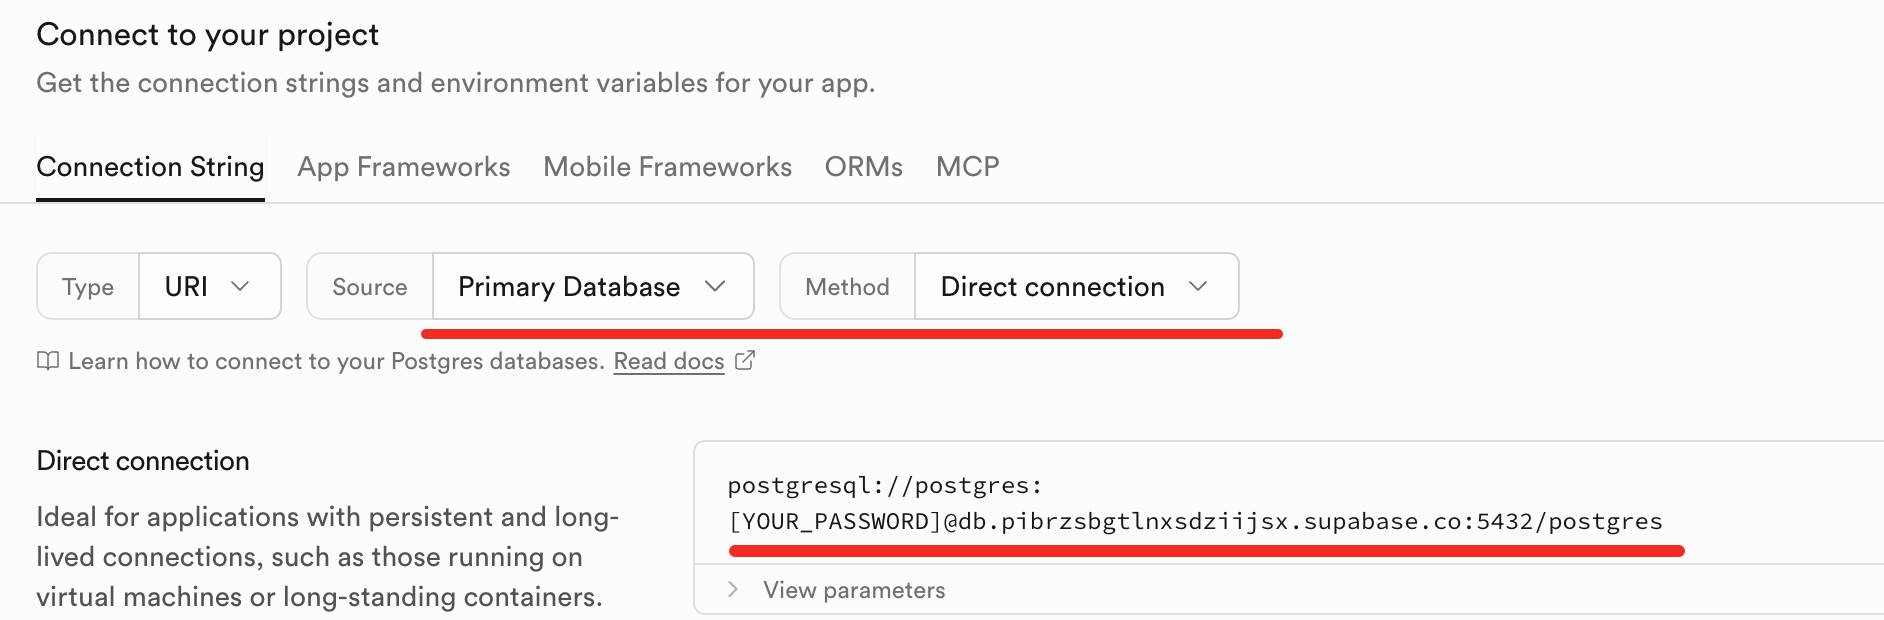
postgres://postgres:[your-password]@db.xxxx.supabase.co:5432/postgres
- Configuration name:自定义名称(如
- 创建完成后,复制生成的 Hyperdrive Configuration ID:
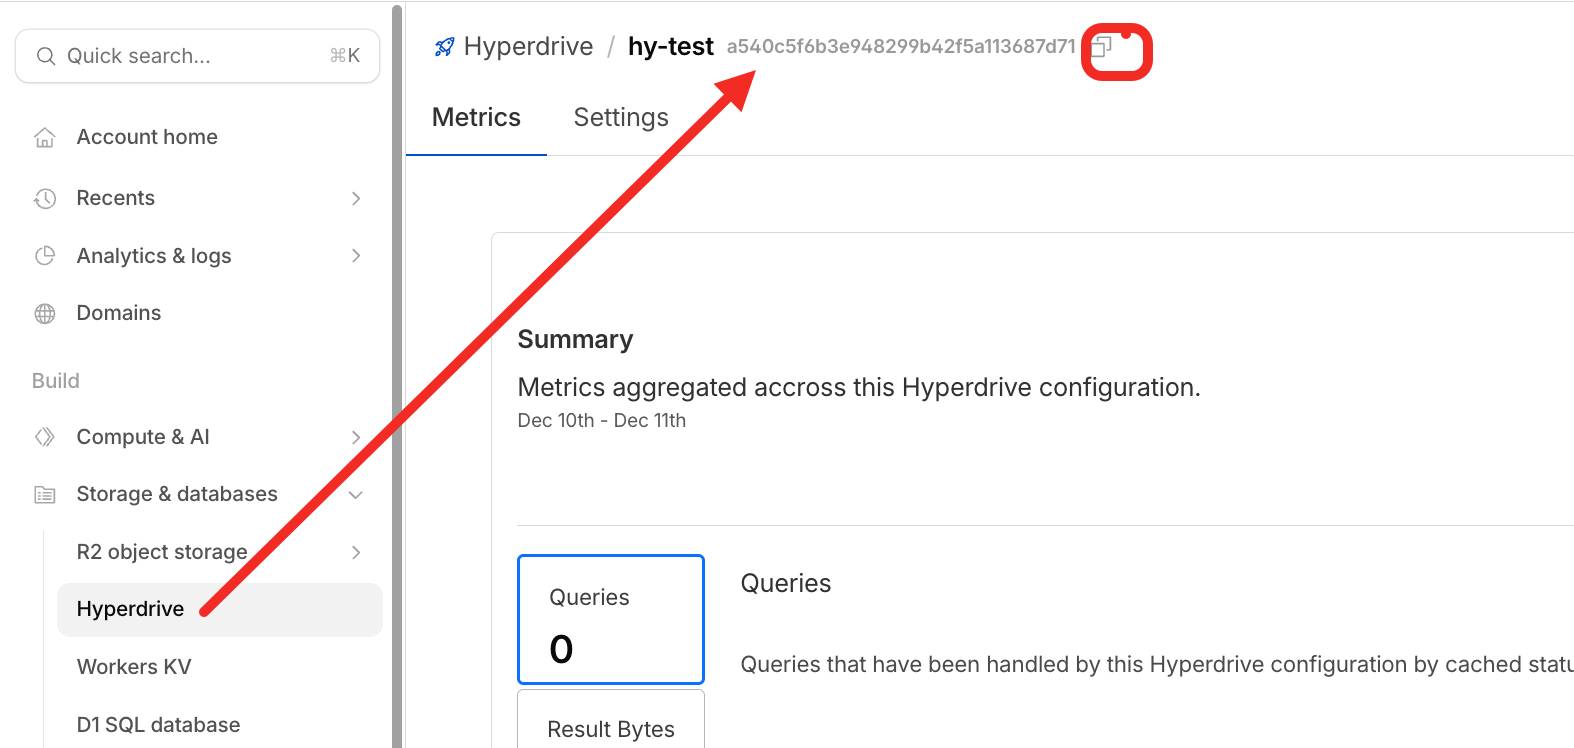
8.2 更新 wrangler.jsonc 配置文件
在 wrangler.jsonc 中将数据库驱动切为 postgresql,注释掉 d1_databases 并加入 hyperdrive 块:
{
  "name": "shipany-template-gpt-image2",
  "vars": {
    "DATABASE_PROVIDER": "postgresql",
    "VITE_APP_URL": "https://你的域名.com",
    "VITE_APP_NAME": "GPT Image2"
  },
  // 开启 Hyperdrive 绑定
  "hyperdrive": [
    {
      "binding": "HYPERDRIVE",
      "id": "填入刚才复制的-hyperdrive-config-id"
    }
  ]
}
8.3 重新部署并生效
执行部署命令:
pnpm cf:deploy
重新部署后,系统会自动通过 Cloudflare Hyperdrive 全球连接池对数据库查询进行连接复用与缓存加速:
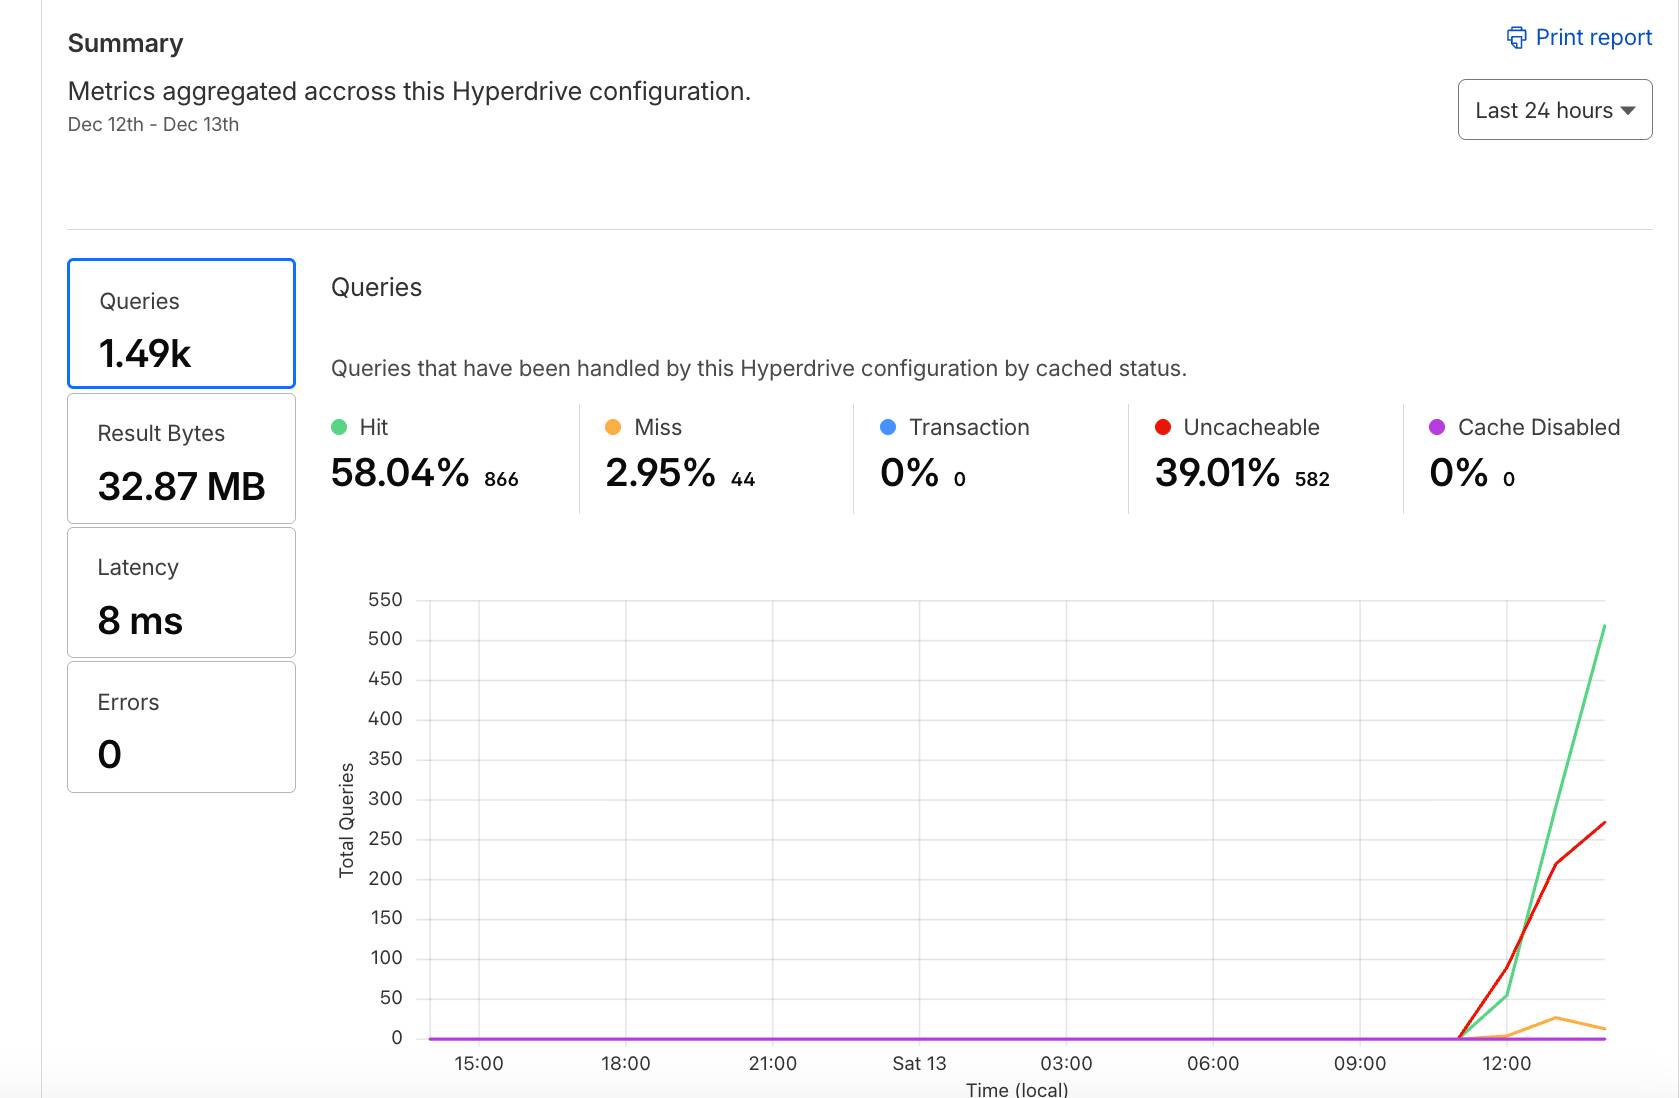
8.4 Hyperdrive 绑定排查指南(Bindings 未生效时)
如果部署后在控制台发现没有出现 Hyperdrive 绑定记录:
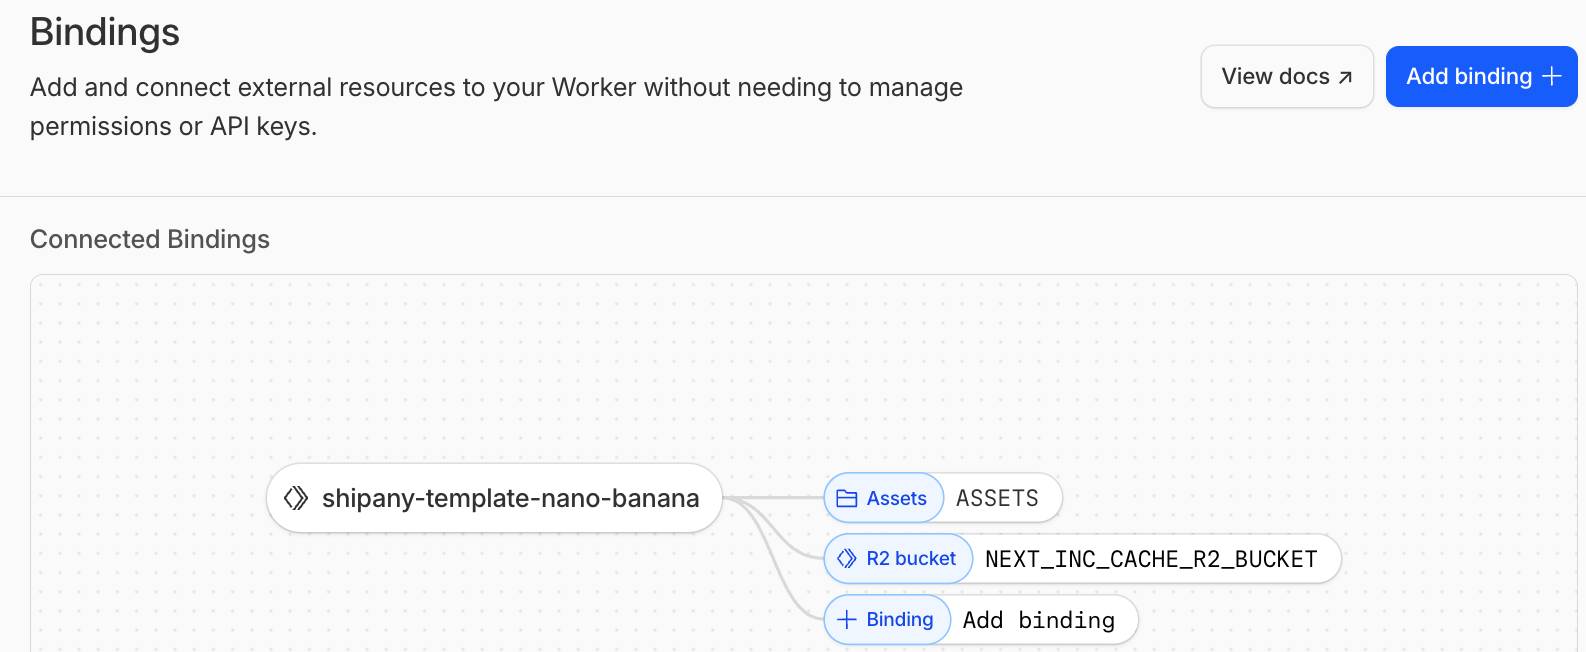
排查方法 1:核对 name 是否一致
打开 wrangler.jsonc,确认文件中的 "name" 与 Cloudflare 控制台里 Workers 项目的实际名称完全一致:
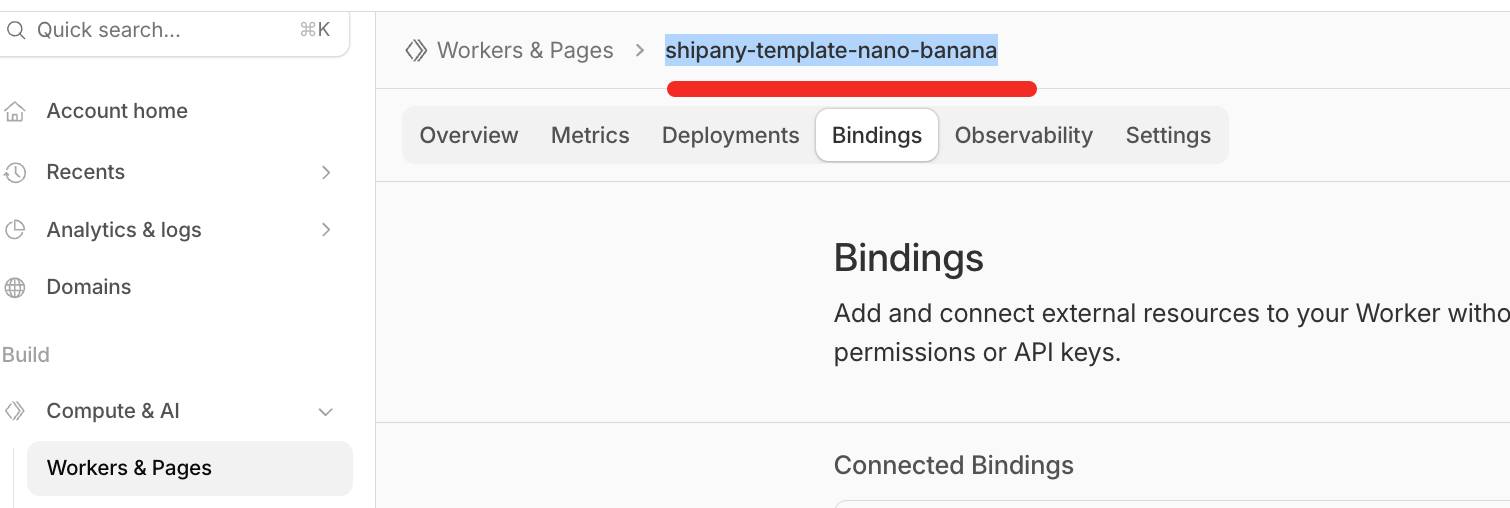
确认后重新执行 pnpm cf:deploy。
排查方法 2:在控制台手动添加绑定
在 Worker 管理后台进入 Settings > Bindings,点击 Add -> 选择 Hyperdrive:
- Variable name:严格填写
HYPERDRIVE - Hyperdrive configuration:选择刚才创建的配置名
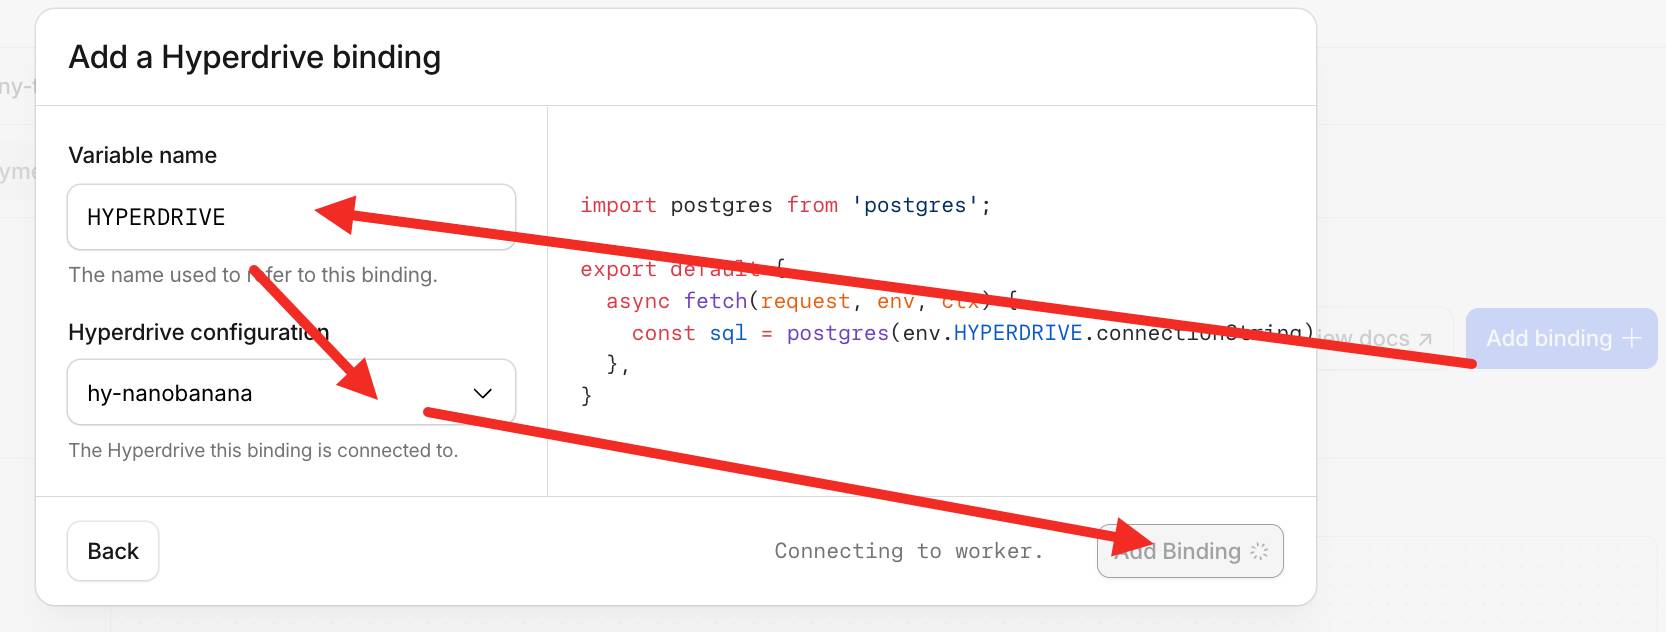
点击保存并部署,绑定即刻生效:
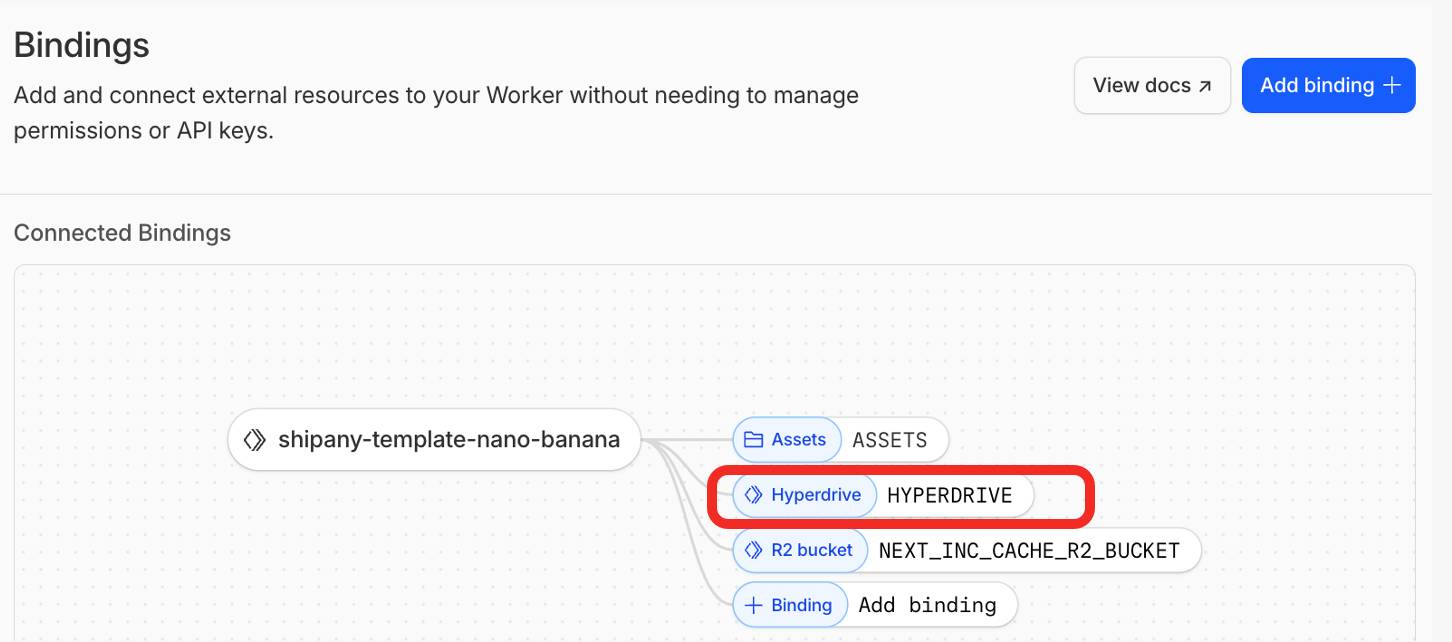
9、 Cloudflare Workers 计划与计费常见问题解答
Q1:免费计划(Free)够用吗?何时需要升级付费计划(Paid,5 美元/月)?
- 免费计划(Free Plan):
- 每天享有 100,000 次请求免费额度。
- Worker 单体体积(gzip)限制为 3 MB(本项目 gzip 约为 1.86 MB,完美适配免费版)。
- 付费计划(Paid Plan - $5/月):
- 拥有每月 10,000,000 次请求额度。
- Worker 体积限制提升到 10 MB。
- 拥有更高的 CPU 运行时间(最高 30 秒)。
Q2:如果刚购买了付费计划后点击“取消/降级”,费用与功能如何计算?
- 在 Cloudflare 控制面板中选择“取消订阅 / 降级到 Free plan”时,该取消操作不会立即中断服务。
- 取消的本质是“关闭下一个周期的自动续费”,当前已经支付的计费周期依然完整有效。
- Cloudflare 不会按天数退还剩余款项,但直到当前账单周期截止日前,你的账号依然享有付费计划(10 MB 限制与高额度请求)的完整权限,可放心用满整月。